三步提取视频提示词:从一条社媒链接到可复用的 AI 视频 Prompt

一条竞品广告跑得不错,客户把链接甩过来,问能不能做个类似的。运营打开视频,看了两遍,开始写提示词:镜头怎么动、光从哪来、节奏多快。写到第三句就卡住了——上一版写的是什么来着?翻聊天记录翻了十分钟,找到的是另一条视频的描述。这种情况在跨平台素材复用里出现得太频繁。
把视频转成提示词这件事,真正的难点不在”写出来”,而在”写出来的东西下次还能用、还能比对”。下面这套流程把提取拆成三步:拿到素材、等分析结果并核对、落进生成工具并归档。每一步都有明确的输入、判断点和返工代价。
先搞清楚要提取什么:一条视频里真正决定复刻成败的六层信息
一条视频能被复刻到什么程度,取决于拆解时覆盖了几层信息。实践里通常拆六层:运动轨迹、镜头语言、构图、视觉风格、光线、时间节奏。少任何一层,生成结果都会呈现”像但不是”的状态——构图对了,运镜方向反了;风格对了,切点全错位。
“看两遍再凭感觉写”在竖屏快切素材上必然失败。TikTok 上一条 15 秒的视频可能包含 20 个以上切点,人眼在第二遍观看时已经进入”理解内容”模式,而不是”记录动作”模式。节奏层的信息在第一次观看时最清晰,之后就模糊了。
值得走提取流程的场景有几类:竞品复刻、旧素材改版、跨平台尺寸重制、给生成模型做风格锚点。其中跨平台重制最容易被低估——同一条素材从 YouTube 横屏长镜头改成小红书竖屏版本,运动描述和节奏描述几乎要重写。
提示词作为可归档产物的价值,在比对时才显现。同一段参考视频用 Veo 和 Kling 分别跑一遍,结果差异出现在哪里——是镜头描述不够细,还是风格词被模型泛化了——只有在提示词层才能定位。如果每次都是现场重写,这个问题永远查不出来。
一条 20 秒以内的视频是整套流程里最小的成本单位。超过这个时长,节奏层的描述会明显变粗,因为分析结果需要压缩到可读长度,切点信息首当其冲被合并。
第一步:粘贴链接,或者直接上传本地文件
入口有两个,取舍很简单:能拿到链接就用链接,拿不到源就走文件上传。客户给的本地样片、内部拍摄素材、已经下架的视频,这些只能走上传。链接入口覆盖 YouTube、TikTok、Instagram、Bilibili、小红书等主流平台,底层依赖 yt-dlp 的能力范围;本地文件支持 MP4、MOV、WebM。
SocialToPrompt 在这条流程里承担的是入口和提取动作。粘贴链接后系统先做一次视频提取,这一步消耗 1 个积分,是三步里最便宜的一步。本地文件上传走的是同一套分析管线,只是跳过了下载环节。
字幕类副产品容易被忽略。SRT、VTT、TXT 三种格式的导出,用途是脚本比对,不是画面复刻。做跨语言版本时,先把原视频字幕导出来对照脚本结构,比直接看画面猜口播内容准确得多。
提交前有三个检查项。时长是否超限——积分估算按 20 秒以内计算,超了要么切段要么接受描述精度下降。画质是否够拆镜头——720p 以下的素材在快切段落里会丢失切点信息。是否含需要脱敏的素材——客户样片里出现未授权的人物或品牌,提取出来的提示词会把这些问题一起带进生成结果。
| 步骤 | 具体操作 | 积分消耗 |
|---|---|---|
| 提取视频 | 粘贴链接或上传本地文件 | 1 积分 |
| 生成提示词 | AI 逐帧分析后输出结构化结果 | 3 积分 |
| 完整一轮流程 | 提取加生成 | 4 积分 |
第二步:等 AI 逐帧分析,检查它到底读懂了什么
分析覆盖运动、镜头、构图、光线、风格、时间轴六个层面,方式是逐帧拆解而非抽帧采样。抽帧采样在快切素材上会直接漏掉切点,逐帧分析的成本更高,但节奏层的信息不会丢。
拿到结构化提示词后的第一件事是核对,不是直接使用。核对两个点:节奏描述是否与成片一致、镜头切换点有没有丢失。快剪素材最常见的偏差是运动描述被合并——三个连续的小幅推镜被写成”缓慢推进”,生成出来就是完全不同的东西。弱光镜头的风格词也容易被泛化,”霓虹反射在湿地面”变成”暗调氛围”,细节全没了。
提示词的结构应该长什么样:可分段、可局部替换、可被生成模型逐条消化。分段指的是运动、镜头、构图、风格、光线、节奏各自独立成段,改其中一段不影响其他段。Veo Prompt 和 Kling Prompt 对颗粒度的容忍度不同,分段结构让同一份提示词能按模型调整,而不是整段重写。
社区里对高质量视频提示词结构的拆解值得看一遍,里面提到的一个判断标准是:如果提示词里出现”电影感”这类词,基本可以判断描述不够具体。
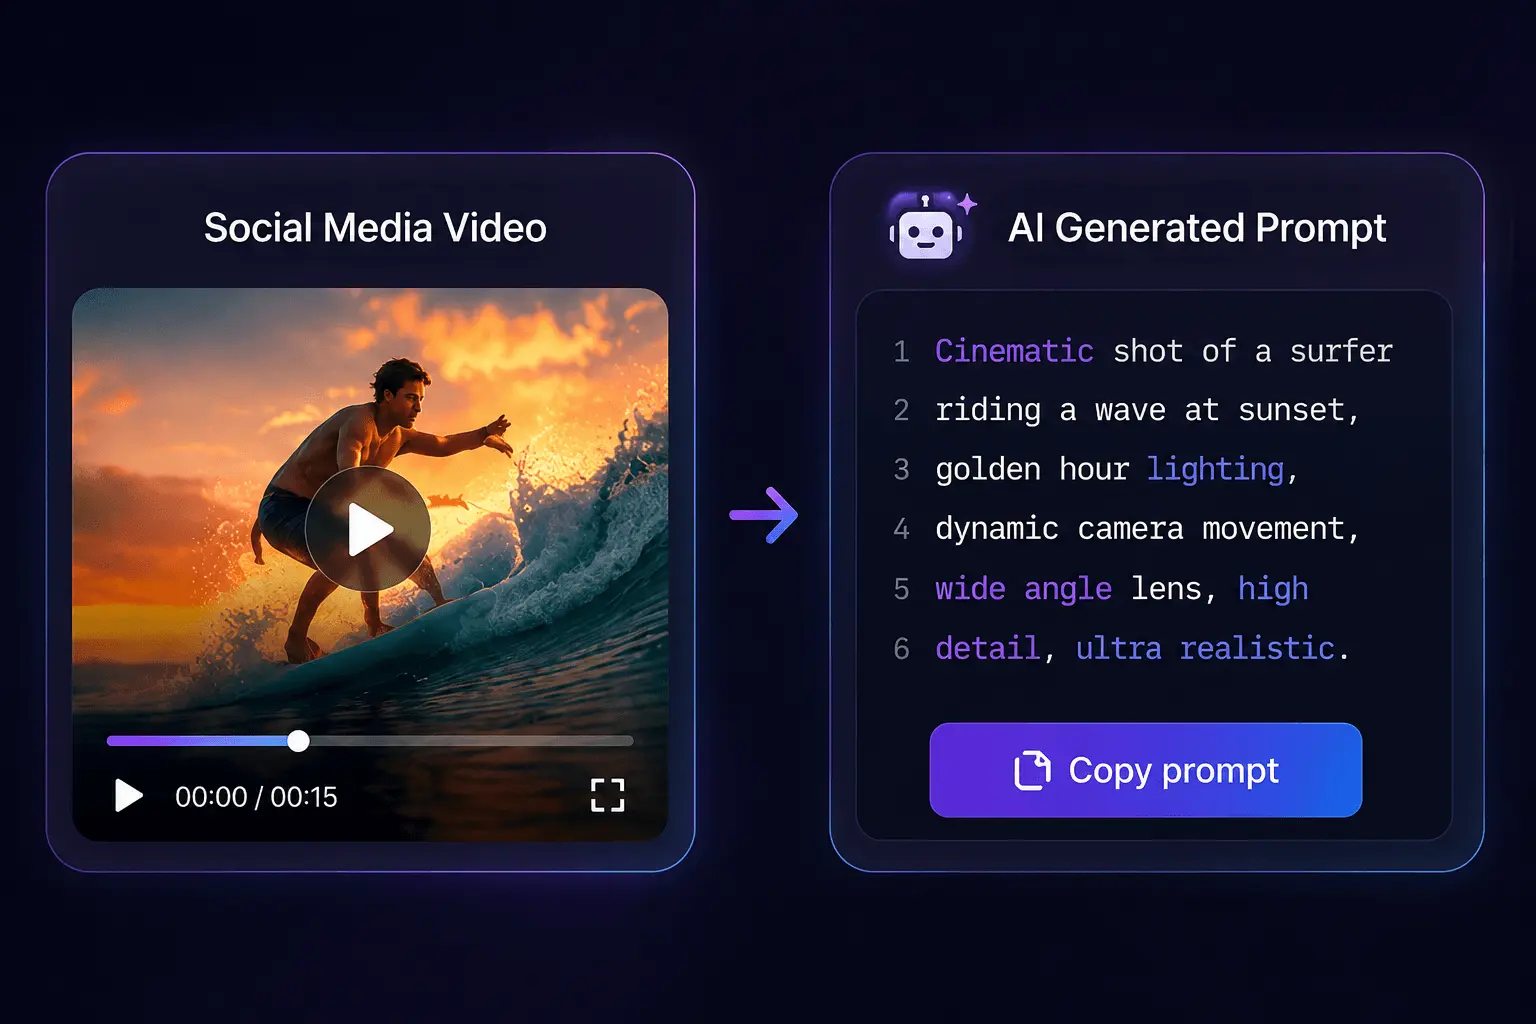
生成提示词消耗 3 个积分,是提取动作的三倍。这个成本结构决定了操作顺序:先看清楚分析结果再点生成,比反复重跑省钱。实际使用里,很多人提交后不看中间结果,直接等最终提示词,发现问题再重跑,一轮下来积分消耗翻倍。
第三步:把提示词落进生成工具,并建立可复用的比对习惯
输出目标的差异比想象中大。Veo、Kling、Seedance、Runway、Sora、Luma、Hailuo、Pika、Vidu、PixVerse 对提示词长度和镜头描述颗粒度的容忍度各不相同。有的模型对长句敏感,描述越细越好;有的模型在超过一定长度后开始忽略后半段。第一次跑不要改提示词,先跑原样版本,把结果与参考视频并排比对,再决定改哪一层。
比对时看差异出现在哪一层。运动不对就改运动段,风格不对就改风格段,不要整段重写。不同生成模型对同一份提示词的还原度差异,通常在第一次生成就能看出来,不需要跑满三轮。
复用策略是把同一条参考视频的提示词拆成”结构模板 + 可变风格段”。结构模板保留运动、镜头、节奏这些与内容强绑定的部分,风格段单独抽出,供后续批量改版时替换。这样一条参考视频的提取结果可以支撑十几次改版,而不是每次从头来。
归档习惯决定两周后能不能回溯。提示词、原始链接、生成结果三者放在一起,否则出了问题只能靠记忆猜是哪一版。SocialToPrompt 的输出在这里的作用是提供一份可存档的中间产物,把”这条视频怎么拍的”固定下来,后续比对时不用重新跑分析。
容易踩的坑:积分、时长、平台差异与复用边界
注册赠送的 3 个积分 24 小时内失效,购买积分包 30 天有效。这个有效期差异导致一个高频失误:新账号注册后先攒着不用,等真要批量测试的时候额度已经清零。批量测试的排期必须按这个节奏倒推——注册当天就得跑完第一轮验证,确认流程可用再考虑购买。
做短视频脚本与钩子时的提示词讨论里提到一个相关判断:脚本层的提示词和画面层的提示词是两套东西,混在一起写会互相干扰。
时长边界是另一个坑。积分估算按 20 秒以内视频计算,一段 2 分钟的长视频直接丢进去,拆出来的节奏描述会变得笼统,等于白花积分。长视频要提前切段,每段控制在 20 秒以内,否则预算和描述精度双输。
平台属性会渗进提示词。TikTok 的竖屏快切和 YouTube 的横屏长镜头,产出的运动与节奏描述颗粒度天然不同。Instagram 的方形或竖屏裁切会改变构图描述,同一份提示词跨平台复用大概率失败。跨平台重制时,运动段和节奏段基本要重写,只有风格段和光线段可以保留。
提示词散落各处导致返工的实操吐槽里描述的场景很典型:三个月后想找某条视频的提示词,发现散在聊天记录、文档、截图里,最后只能重新跑一遍。
复用边界要说清楚:提取的是”这条视频怎么拍的”,不是”这条视频为什么有效”。脚本钩子层的问题提示词解决不了——前 3 秒留人的机制、评论区的互动设计、投放时段的匹配,这些不在提取范围内。指望用提示词复刻一条爆款的内容策略,方向就错了。
FAQ
提取一条视频大概消耗多少积分?
提取视频 1 个积分,生成提示词 3 个积分,完整一轮 4 个积分。积分估算按 20 秒以内的视频计算,超过这个时长需要切段后分别处理,总消耗按段数累加。
免费额度和购买的积分包,有效期分别是多久?
注册赠送的 3 个积分 24 小时内失效,购买积分包 30 天有效。批量测试排期要按这个节奏倒推,注册当天跑完第一轮验证,确认流程可用再决定是否购买。
支持哪些视频平台?可以直接上传本地文件吗?
支持 yt-dlp 覆盖的所有平台,包括 YouTube、TikTok、Instagram、Bilibili、小红书等主流社媒。本地文件上传支持 MP4、MOV、WebM 三种格式,走同一套分析管线。
生成的提示词能直接喂给哪些 AI 视频生成模型?
Veo、Kling、Seedance、Runway、Sora、Luma、Hailuo、Pika、Vidu、PixVerse 等主流模型都可以。不同模型对提示词长度和镜头描述颗粒度的容忍度不同,建议先跑原样版本再按模型调整。
时长超过 20 秒的视频怎么处理更划算?
提前切段,每段控制在 20 秒以内。直接提交长视频会导致节奏描述被压缩合并,切点信息丢失,生成结果与参考视频的偏差明显增大,等于白花积分。
分享文章


