كيفية عكس هندسة فيديو اجتماعي إلى موجه فيديو بالذكاء الاصطناعي يعمل
هناك إيقاع مألوف لهذا الفشل. يراقب المبدع مقطعًا يحتوي على حركة دولي مميزة، وتغيّر إضاءة صعب عند علامة الثانية الثانية عشر، ونمط قطع يلتقط كل أربع نبضات. يفتح أداة الفيديو بالذكاء الاصطناعي التي يفضلها ويبدأ بالكتابة. بعد ثلاثين دقيقة، تكون النتيجة المولدة بانوراما عامة عبر غرفة عامة دون أي من التوتر الذي كان في الأصل. يُغلق المقطع. يُدفن مسودة الموجه في سلسلة محادثة. يتكرر الدورة مع الفيديو التالي الذي يجذب انتباهه.
المشكلة الأساسية ليست في المفردات أو الإبداع. إنما أن الإنسان الذي يشاهد مقطعًا مدته ستين ثانية يلاحظ ربما خمسة أو ستة تفاصيل بارزة، بينما يركز نموذج التوليد على عشرات القرارات الدقيقة في كل ثانية. لا أحد يستطيع كتابة تلك الكثافة يدويًا من الذاكرة. الحل الفعّال هو التوقف عن وصف ما يبدو عليه الفيديو والبدء في استخراج البنية المشفّرة بالفعل في اللقطات نفسها.
لماذا فشل كتابة موجهات الفيديو من الذاكرة
الشخص الذي يشاهد مقطعًا يلاحظ الموضوع، المزاج، ربما تصحيح اللون. يحتاج نموذج التوليد إلى معرفة سلوك البعد البؤري، السرعة الدقيقة لحركة الكاميرا، متى يتغير الإضاءة بالنسبة للإجراء، وكيف يتفاعل نمط القطع مع مسار الموضوع. هذين القائمتين لا تتقاطع إلا قليلًا. عادةً ما تكون مقاطع الفيديو الاجتماعية بين 30 و120 ثانية، لذا يضغط مقطع واحد عشرات قرارات الكاميرا والتوقيت التي يجب أن يحملها الموجه.
تظهر الفجوة في ما يُهمل. عادةً ما تكون حركة الكاميرا أول ضحية، لأنها غير مرئية إلا إذا كنت تتبعها بنشاط. التوقيت هو الثاني، لأنه يوجد فقط بالنسبة للأحداث الأخرى. ما يبقى هو مجموعة من الصفات الغامضة — “سينمائي”، “مُظلم”، “دYNAMIC” — كل — يفسره النموذج بشكل مختلف ولا يفسره أحد جيدًا.
هناك أيضًا الفشل التنظيمي. تتكاثر مسودات الموجهات عشوائيًا عبر السلاسل، المستندات، وتاريخ المحادثات. نسخة واحدة في رسالة Discord، أخرى في مستند Google، وثالثة في رسالة خاصة. عندما يُستعاد المشروع بعد ثلاثة أسابيع، لا أحد يستطيع العثور على النسخة التي نجحت فعليًا، لذا تُعاد كتابتها من الصفر. يصبح العبء الناتج عن تخزين الموجهات المتناثرة ضريبة عملية خاصة به.
يتفاقم عدم الاتساق عندما يُعاد استخدام نفس الموجه عبر مشاريع مختلفة. يبني فريق التسويق نسخة إعلان من موجه نجح في حملة سابقة. بعد ستة أشهر، ينتج نفس الموجه شيئًا بصريًا غير ذي صلة، لأن نسخة النموذج في الأداة تغيرت تحته. النسخة المخزنة التي أعادت مظهرًا موثوقًا في نسخة واحدة تتوقف عن العمل بصمت بعد التحديث، مما يجبر الفريق على إعادة استخراج الموجه من اللقطات الأصلية مرة أخرى.
| العامل | وصف المقطع يدويًا | استخراج من الفيديو الأصلي |
|---|---|---|
| التفاصيل البصرية الملتقطة | عدد قليل من الانطباعات البارزة | حركة وإطار الكاميرا والبيانات الزمنية على مستوى الإطار |
| الوقت المستغرق لكل مقطع | 15–40 دقيقة من الصياغة | ثوانٍ من التحليل الآلي |
| الاتساق عبر المسودات | يتغير مع كل إعادة كتابة | بنية حقل ثابتة |
| إعادة الاستخدام في أداة AI أخرى | يتطلب إعادة وصف كاملة | يتناسب مع تعديلات بسيطة |
تكلفة هذا عدم الاتساق نادراً ما تظهر في اللحظة. تظهر لاحقًا، عندما يتعطل نمط استغ أسبوع لتأسيسه بهدوء ولا يستطيع أحد إعادة بناء ما تغير.
ما الذي يجب أن يصفه موجه الفيديو فعليًا
يحمل موجه الفيديو الوظيفي ستة أبعاد: الحركة، عمل الكاميرا، التركيب، الأسلوب، الإضاءة، والتوقيت. تغطي موجهات الصور الثابتة التركيب والأسلوب بشكل معقول، لكنها لا تملك مفردات لتفاصيل المستوى التسلسلي. سرعة التحريك، إيقاع القطع، مسار الموضوع عبر إطار 40 إطارًا — هذه هي المعايير التي تميز موجه الفيديو عن موجه الصورة مع كلمات إضافية.
حجم المشكلة يستحق أن يُذكر صراحةً. مقطع مدته 30 ثانية بمعدل 30 إطارًا في الثانية يعني حوالي 900 إطار، ما يعني أن موجهًا مبنيًا على انطباع ذهني واحد يتجاهل تقريبًا كل المعلومات البصرية التي يمكن للنموذج استخدامها. النماذج نفسها لا تسامح مع هذا الفقدان. إنها تولد من المعايير التي تُعطى لها، وتملأ الفجوات بفرضيات إحصائية خاصة بها.
السلوكلوك السلوك الس السير أكثر في أ كلمات. الإس. إلىار “توهج الساعة الذهبية” ينتج صبغة دافئة عامة. “ضوء رئيسي صلب من اليسار، ظلال تتلاشى عبر الخلفية بنسبة 40 بالمئة” ينتج شيئًا أقرب إلى قرار إضاءة فعلي. الفرق هو الفرق بين كلمات المزاج والمواصفات التشغيلية.
قواعد الموجه حساسة للإصدار أيضًا. يُفسر نفس الموجه المنظم بشكل مختلف عبر إصدارات الأدوات — Veo، Kling، Runway، Sora، Luma، وSeedance جميعها تحلل بنية الموجه عبر أولوياتها المدربة الخاصة. قد ينتج صياغة تُظهر دفعًا بطيئًا في نسخة نموذج واحدة لقطة واسعة ثابتة في النسخة التالية. لهذا السبب ربط الموجه بالقطات الفعلية أهم من صقل صياغته. تُظهر أنماط القوالب الموجهات المتداولة على TikTok مدى تنوع المعايير، لكنها نادرًا ما تحل مشكلة الدقة لأنها عامة بحكم التصميم.
عكس هندسة مقطع إلى موجه منظم
العمل العملي هو عملية من ثلاث خطوات. خذ عنوان URL للفيديو الأصلي، دع التحليل يجري على اللقطات، وتلقى موجهًا منظمًا يلتقط الحركة، الكاميرا، الأسلوب، الإضاءة، والتوقيت كحقول صريحة. المفتاح هو أن التحليل يحدث إطارًا بإطار، وليس كملخص أولي. نموذج يراقب كل إطار يمكنه أن يبلغ أن الكاميرا تدفع إلى الأمام على مدى 90 إطارًا بينما يتحرك الموضوع إلى اليسار، وأن درجة حرارة الإضاءة تتغير عند الإطار 360، وأن نمط القطع يعمل على فاصل إيقاع أربع نبضات. إنسان يراقب نفس المقطع لن يلاحظ أيًا من ذلك بوعي.
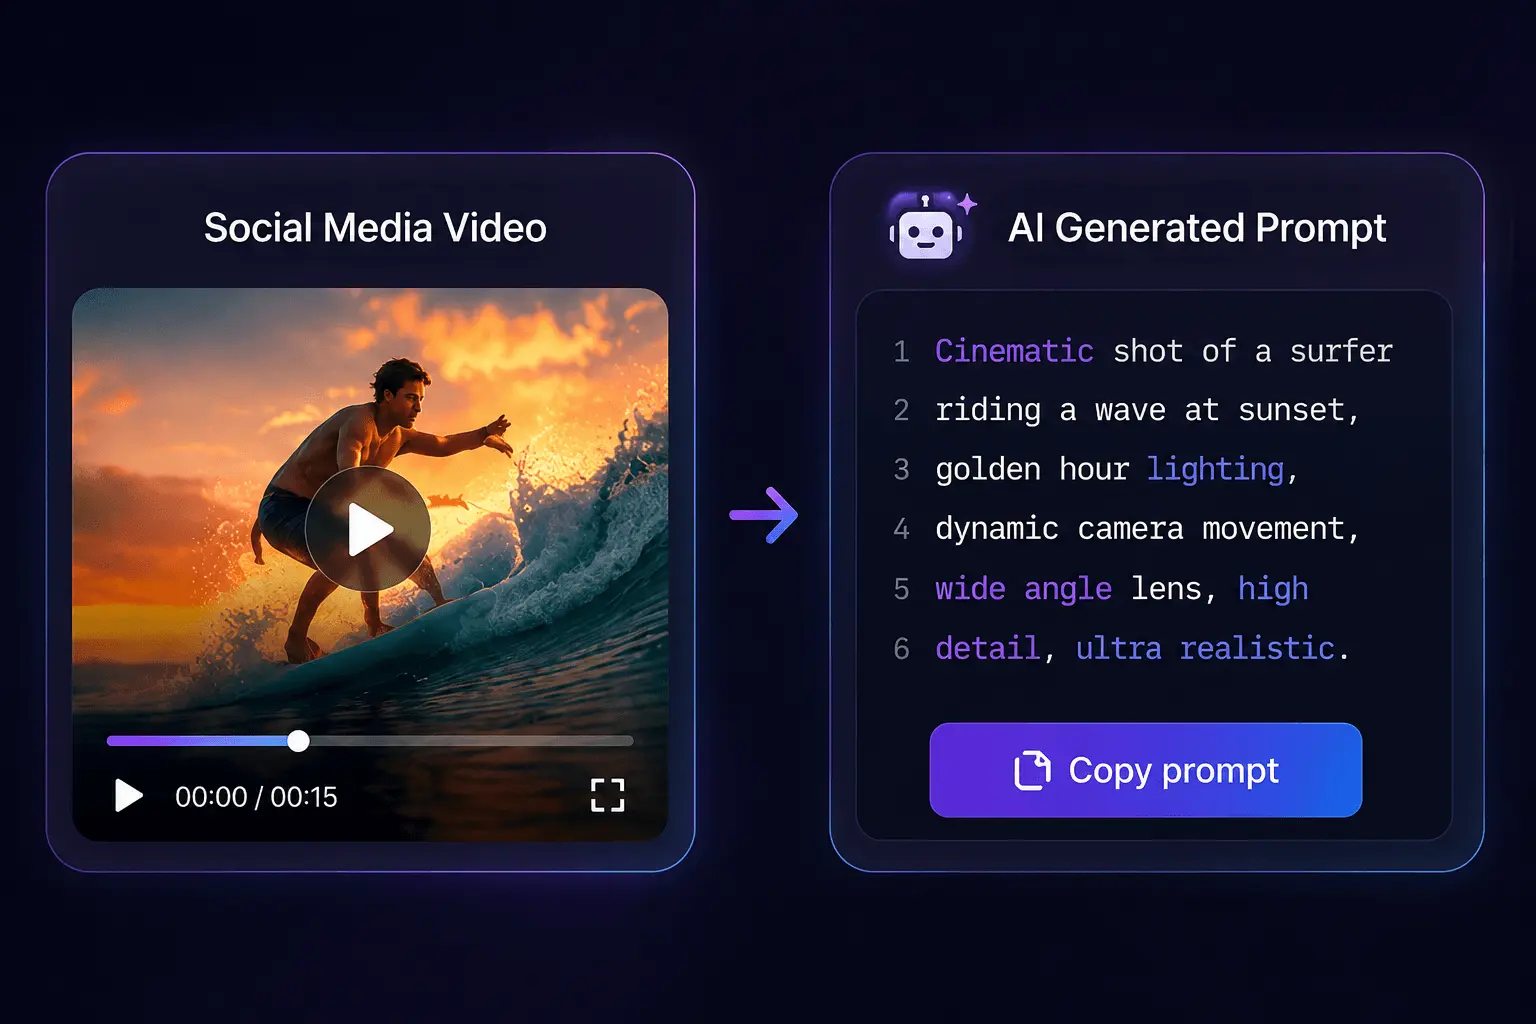
المصادر الأولية أوسع مما يظن معظم الناس. يغطي YouTube، TikTok، Instagram، Reddit، Bilibili، وXiaohongshu معظم المقاطع العامة، لكن الأنابيب تمتد إلى الملفات المحلية عندما لا تكون اللقطات منشورة في أي مكان. تدعم تحميلات MP4، MOV، وWebM المواد الخاصة أو غير المنشورة التي لا تصل إلى منصة عامة.
الراحة العملية في معالجة التحميل وتوليد الموجه في تمريرة واحدة أهم مما يبدو. البديل المعتاد هو التلاعب بأداة تحميل، خطوة تحويل ملف، وجلسة كتابة موجه منفصلة عبر ثلاث أدوات مختلفة. دمج ذلك في تمريرة واحدة يزيل قدرًا مفاجئًا من الاحتكاك. إحدى الخدمات التي تُ automate هذا التحليل هي SocialToPrompt، التي تُجري الاستخراج وتوليد الموجه في نفس الخطوة بدلاً من الحاجة إلى تسليم يدوي بين الأدوات.
المحاسبة المالية واضحة. يستخدم مقطع مدته 30 ثانية تقريبًا 6 أرصدة — 1 للاستخراج و1 لكل 5 ثوانٍ من الفيديو المُحلل. مقطع مدته دقيقتين يستخدم حوالي 25 رصيدًا. لا يوجد ضغط انتهاء صلاحية على الرصيد، مما يزيل القلق المتعلق بالاشتراك الذي عادةً ما يصاحب هذه الأدوات. تغطي المخرجات أكثر من 30 منصة مصدر عبر أنابيب واحدة، مما يلغي الحاجة إلى أدوات تحميل منفصلة لكل منصة.
نقل الموجه المكتمل بين أدوات AI
القابلية للنقل هي السؤال الذي يحدد ما إذا كان هذا workflow سيتوسع أم سيظل حيلة لمرة واحدة. تُفسر المولدات المختلفة بنية الموجه بطريقة مختلفة، لذا قد يحتاج موجه مستخرج يعمل حرفيًا في أداة إلى تعديلات على مستوى الحقول في أداة أخرى. التوقع الواقعي هو أن الدقة تكون أعلى عندما يكون الهدف هو إعادة إنشاء المظهر الأصلي، وإعادة دمجه في شيء جديد يتطلب تعديل الحقول بدلاً من إعادة كتابة من الصفر.
في الممارسة العملية، يتصرف الموجه المنظم بشكل معقول عندما يُلصق في Veo، Gemini، Kling، Runway، Sora، Luma، Wan، أو Hailuo. تُترجم حقول الحركة والكاميرا بسلاسة عبر معظمها. حقول الأسلوب والإضاءة هي التي تختلف في التفسير، لأن كل نموذج لديه قواعده البصرية المتعلمه. تم تصميم مخرجات SocialToPrompt لتُسقط في مولدات متعددة دون الحاجة إلى إعادة وصف المقطع، مما يزيل القفل على أداة واحدة الذي تُنشئه الموجهات اليدوية عادةً.
العادة التي تنجح هي الحفاظ على الموجه المستخرج كمرجع ثابت مع إجراء تعديلات خاصة بالأداة لكل تشغيل. يبقى الإصدار المستخرج غير معدل كمصدر للحقائق. يحصل كل أداة على نسخة معدلة مع تعديلات خاصة به. هذا يمنع الانحراف الذي يحدث عندما يحرر شخص ما الموجه الرئيسي مباشرة ويفقد الدقة الأصلية.
ما لا يفعله هذا workflow هو القضاء على الحاجة إلى الحكم. يُعيد الموجه المستخرج المظهر الأصلي بدقة عالية، لكن اتخاذ قرار ما إذا كان هذا المظهر ما تريد لمشروع معين لا يزال قرارًا إبداعيًا. تُزيل الأدوات عبء النسخ، لا النية.
الأسئلة المتكررة
هل يمكن لموجه مستخرج من فيديو إعادة إنتاج المقطع الأصلي بدقة؟
لا، ليس بدقة تامة. يُعيد إنتاج المعايير الهيكلية — الحركة، الكاميرا، الإضاءة، التوقيت — بدقة عالية، لكن نماذج التوليد تُضيف تنوعها الخاص في كل تشغيل. ما ستحصل عليه هو نسخة تحمل نفس القرارات البصرية، وليس نسخة مطابقة للإطار.
ما هي الصيغ والمنصات التي يمكن أن يأتي منها الفيديو الحالي؟
أي منصة يدعمها yt-dlp، وهو ما يغطي YouTube، TikTok، Instagram، X، Reddit، Bilibili، Xiaohongshu، Kuaishou، Vimeo، Twitch، وحوالي 20 أخرى. التحميلات المحلية بصيغة MP4، MOV، أو WebM تعمل عندما لا يُنشر المقطع علنًا.
هل ينتج نفس الموجه نتائج متسقة عبر أدوات فيديو AI مختلفة؟
سيتم تفسير الموجه في جميعها، لكن الناتج سيتفاوت لأن كل نموذج لديه أولوياته المدربة الخاصة. تنتقل حقول الحركة والكاميرا بأكثر موثوقية. تحتاج حقول الأسلوب والإضاءة إلى تعديل لكل أداة.
ما الفرق بين قالب موجه وموجه مستخرج من لقطات فعلية؟
القالب هو بنية عامة مع أماكن مملوءة بالتفاصيل التي يضيفها المستخدم بنفسه. الموجه المستخرج من لقطات فعلية يحتوي على المعايير المقاسة فعليًا من مقطع محدد. القوالب قابلة لإعادة الاستخدام لكنها غامضة. الموجهات المستخرجة محددة لكنها مرتبطة بالمصدر الذي أُخذت منه.
مشاركة المقال